
nvidia/ai-factory-operations-agent
Developer toolsЭта страница переведена автоматически. Технические детали смотрите в оригинале. Открыть оригинал
Развертывайте агентов ИИ для расследования проблем кластеров и оптимизации управляемых заводских операций ИИ.
Обзор
Развертывайте специализированных агентов ИИ для изучения проблем кластеров и оптимизации управляемых заводских операций ИИ. Это экспериментальный релиз. Пожалуйста, обратитесь к SUPPORT.md перед установкой. AI Factory Operations Agent - это проект NVIDIA для развертывания расширяемой структуры агентных операций, построенной с помощью NemoClaw. Специализированные агенты собирают и сопоставляют доказательства в кластерных системах, генерируют четкие сводки первопричин и рекомендуют следующие шаги с помощью управляемых, проверяемых рабочих процессов, которые команды могут адаптировать к своим собственным средам производства ИИ. - Рабочая нагрузка Kubernetes и контроль кластера. - Запросы Prometheus и VictoriaMetrics и создание панели инструментов Grafana. - Анализ первопричины нечистоты с помощью планировщика и лог-доказательств. - Необязательные интеграции кластерного управления. - Исполнение команд в песочнице с проверяемым рабочим процессом агента. OpenShell изолирует исполнение командных команд.
Обзор (машинный перевод)
Развертывайте специализированных агентов ИИ для изучения проблем кластеров и оптимизации управляемых заводских операций ИИ.
Обзор
[!ПРИМЕЧАНИЕ] Это экспериментальный релиз. Пожалуйста, обратитесь к SUPPORT.md перед установкой.
AI Factory Operations Agent - это проект NVIDIA для развертывания расширяемой структуры агентных операций, построенной с помощью NemoClaw. Специализированные агенты собирают и сопоставляют доказательства в кластерных системах, генерируют четкие сводки первопричин и рекомендуют следующие шаги с помощью управляемых, проверяемых рабочих процессов, которые команды могут адаптировать к своим собственным средам производства ИИ.
Поддерживаемые рабочие процессы включают:
- Рабочая нагрузка Kubernetes и контроль кластера.
- Запросы Prometheus и VictoriaMetrics и создание панели инструментов Grafana.
- Анализ первопричины нечистоты с помощью планировщика и лог-доказательств.
- Необязательные интеграции кластерного управления.
- Исполнение команд в песочнице с проверяемым рабочим процессом агента.
Архитектура
OpenShell изолирует исполнение командных команд. Kubernetes, наблюдаемость, Slurm и Base Command Manager используют инструменты на стороне сервера, специфичные для модулей, и учетные данные, явно настроенные для этих модулей.
Эта страница переведена автоматически. Технические детали смотрите в оригинале.
README
Показан фрагмент оригинального README. Открыть оригинал.
AI Factory Operations Agent
Deploy specialized AI agents to investigate cluster issues and streamline governed AI factory operations.
Overview
[!NOTE] This is an experimental release. Please reference SUPPORT.md prior to installation.
AI Factory Operations Agent is an NVIDIA blueprint for deploying an extensible agentic operations framework built with NemoClaw. Specialized agents gather and correlate evidence across cluster systems, generate clear root cause summaries, and recommend next steps through governed, auditable workflows that teams can adapt to their own AI factory environments.
Supported workflows include:
- Read-only Kubernetes workload and cluster inspection.
- Prometheus and VictoriaMetrics queries and Grafana dashboard creation.
- Slurm job root-cause analysis from scheduler and log evidence.
- Optional cluster-management integrations.
- Sandboxed command execution with an auditable agent workflow.
Architecture
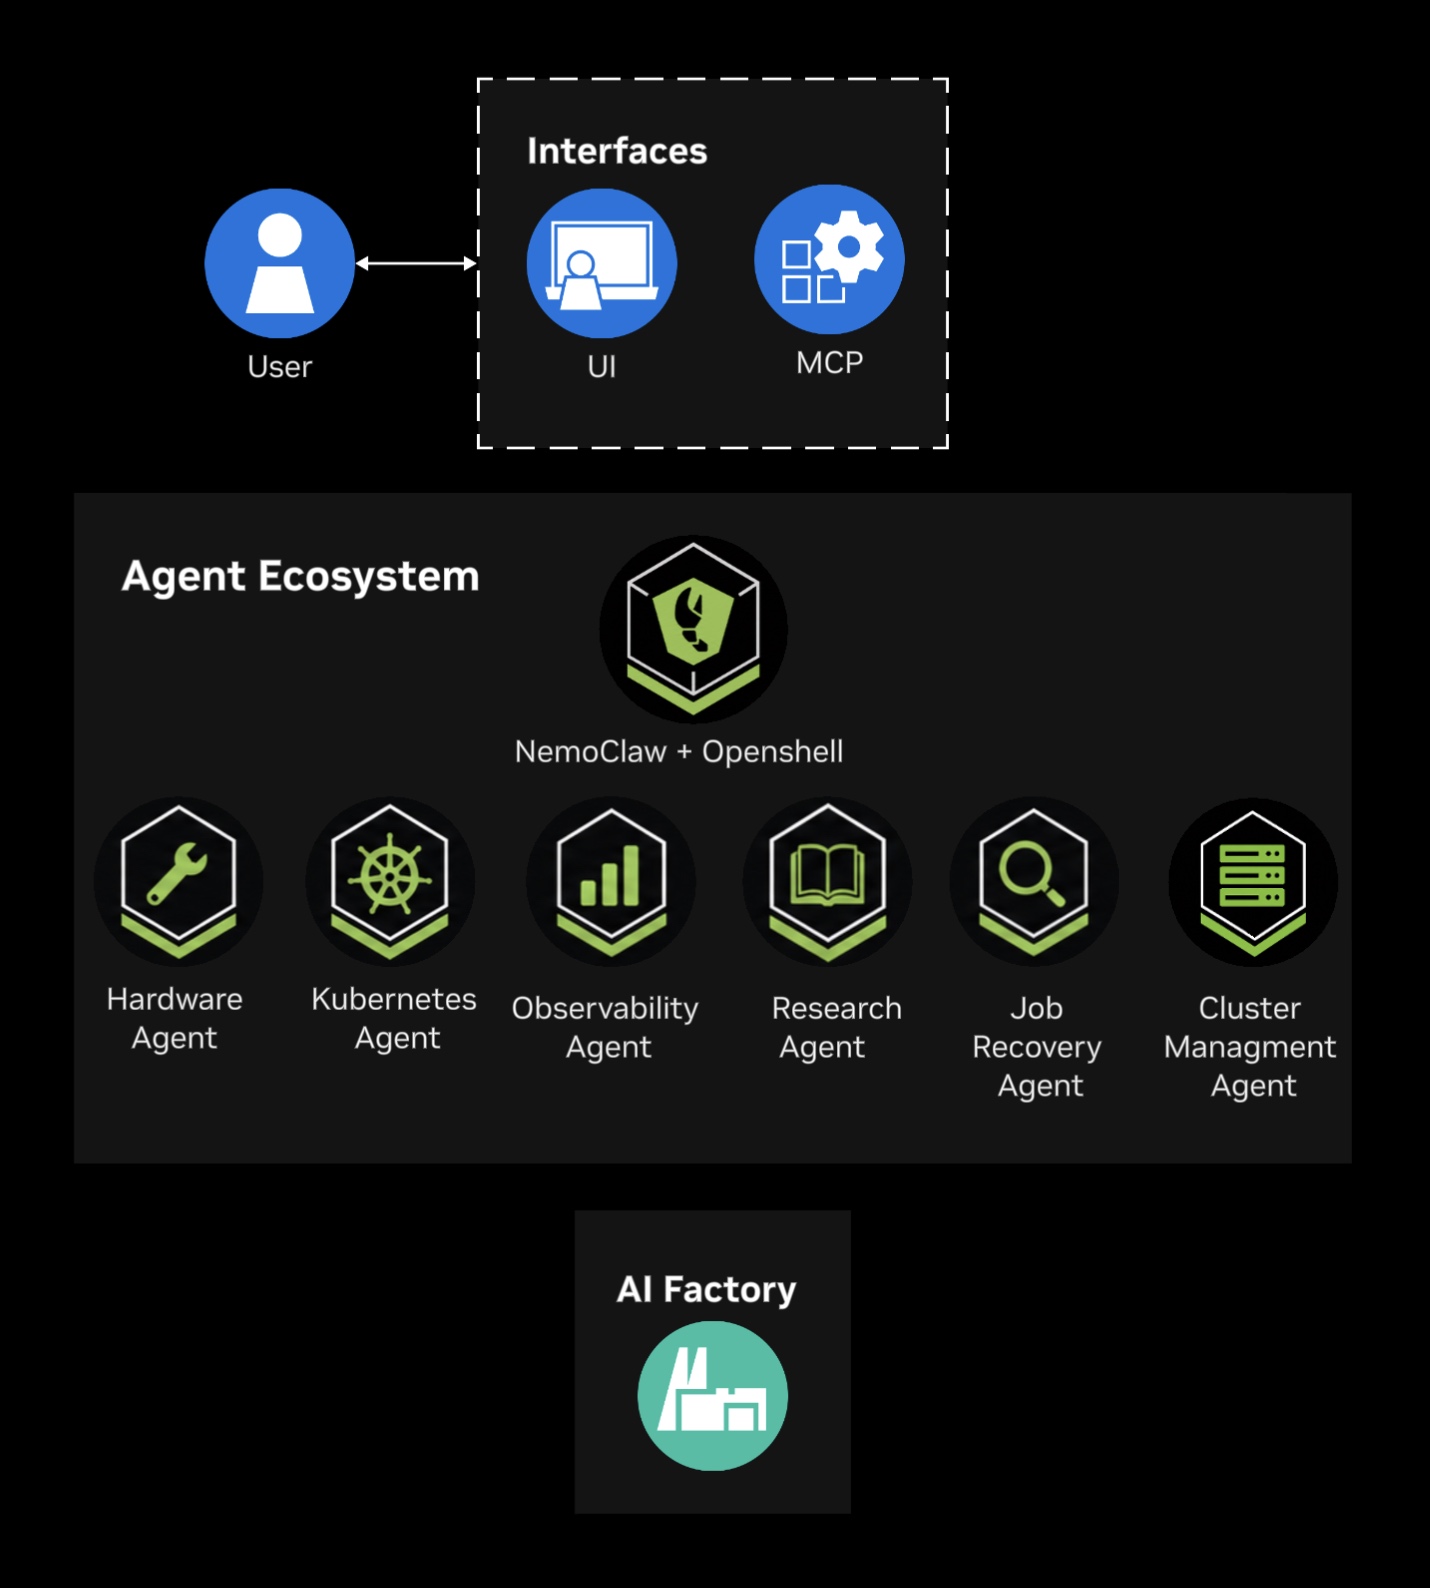
OpenShell isolates general agent command execution. Kubernetes, observability, Slurm, and Base Command Manager access use module-specific server-side tools and the credentials explicitly configured for those modules. Browser and MCP clients do not receive cluster credentials. Kubernetes Secrets remain mounted only in the pods that require them.
Requirements
- OS/architecture: a Kubernetes environment compatible with the container images selected in Helm values.
- Runtime: Kubernetes,
kubectl, and Helm 3. - LLM: an OpenAI-compatible endpoint or a cluster capable of running chart-managed vLLM.
- GPU/driver: required only when deploying chart-managed vLLM; requirements depend on the selected model profile.
- Optional services: Prometheus or VictoriaMetrics, Grafana, Slurm, or cluster-management endpoints for the corresponding modules.
Getting Started
The documentation site can be built locally from the guides in this repository. See Building the documentation.
In the early access stage, the published Helm chart and container images require an early access invitation to the private NGC registry; nvcr.io login alone does not grant pull access. To request access before installing, complete the onboarding form or email [email protected]. You can also contact your NVIDIA account team.
Use the complete installation guide for your environment:
Рекомендуемые инструменты
Попробуйте другой запрос или уберите фильтр.
Установка
npx skillfish add nvidia/ai-factory-operations-agent