
petabridge/memorizer
Developer toolsЭта страница переведена автоматически. Технические детали смотрите в оригинале. Открыть оригинал
petabridge/memorizer — это кандидат на MCP-сервер, импортированный из https://github.com/petabridge/memorizer.
Обзор
petabridge/memorizer — это кандидат на MCP-сервер, импортированный из https://github.com/petabridge/memorizer.
Обзор (машинный перевод)
Memorizer — это сервис на базе . NET, который позволяет агентам искусственного интеллекта хранить, извлекать и искать в памяти с помощью векторных вложений. Он использует PostgreSQL с расширением pgvector для обеспечения эффективных возможностей поиска сходства.
Ключевые особенности:
- Workspaces & Projects — Организовать память в иерархические рабочие пространства и проекты с отслеживанием статуса
- Хранение структурированных памяти с векторными вложениями
- Извлечение воспоминаний по ID
- Семантический поиск по памяти с использованием векторного сходства
- Фильтрация результатов поиска с помощью тегов
- Редактировать содержимое памяти с автоматическим набором версий и отслеживанием изменений
- Независимо обновлять метаданные памяти (название, тип, теги, доверие)
- Восстановить воспоминания к предыдущим версиям с полным аудитом
- Создание связей между воспоминаниями для формирования графов знаний
- Веб-интерфейс для ручного добавления, редактирования, удаления, просмотра памяти и управления версиями
- Настройки провайдера — Настройка встраивающих и LLM-провайдеров через интерфейс (Ollama, OpenAI и совместимые API)
- Интеграция MCP (Протокол контекста модели) для удобства использования с агентами ИИ
- Поддержка темы Light и Dark
Технологии
- .NET 10.0
- PostgreSQL с расширением pgvector
Эта страница переведена автоматически. Технические детали смотрите в оригинале.
README
Показан фрагмент оригинального README. Открыть оригинал.
Memorizer


Memorizer is a .NET-based service that allows AI agents to store, retrieve, and search through memories using vector embeddings. It leverages PostgreSQL with the pgvector extension to provide efficient similarity search capabilities.
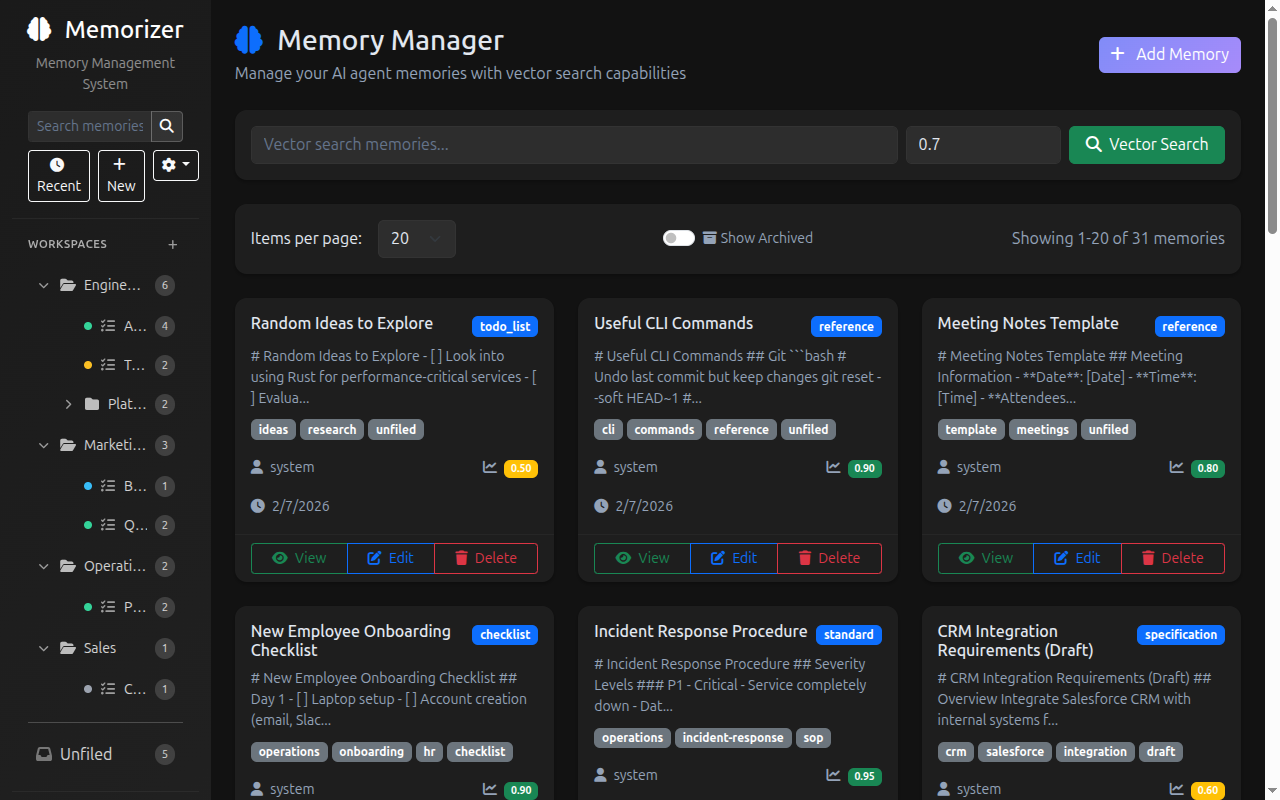
Key features:
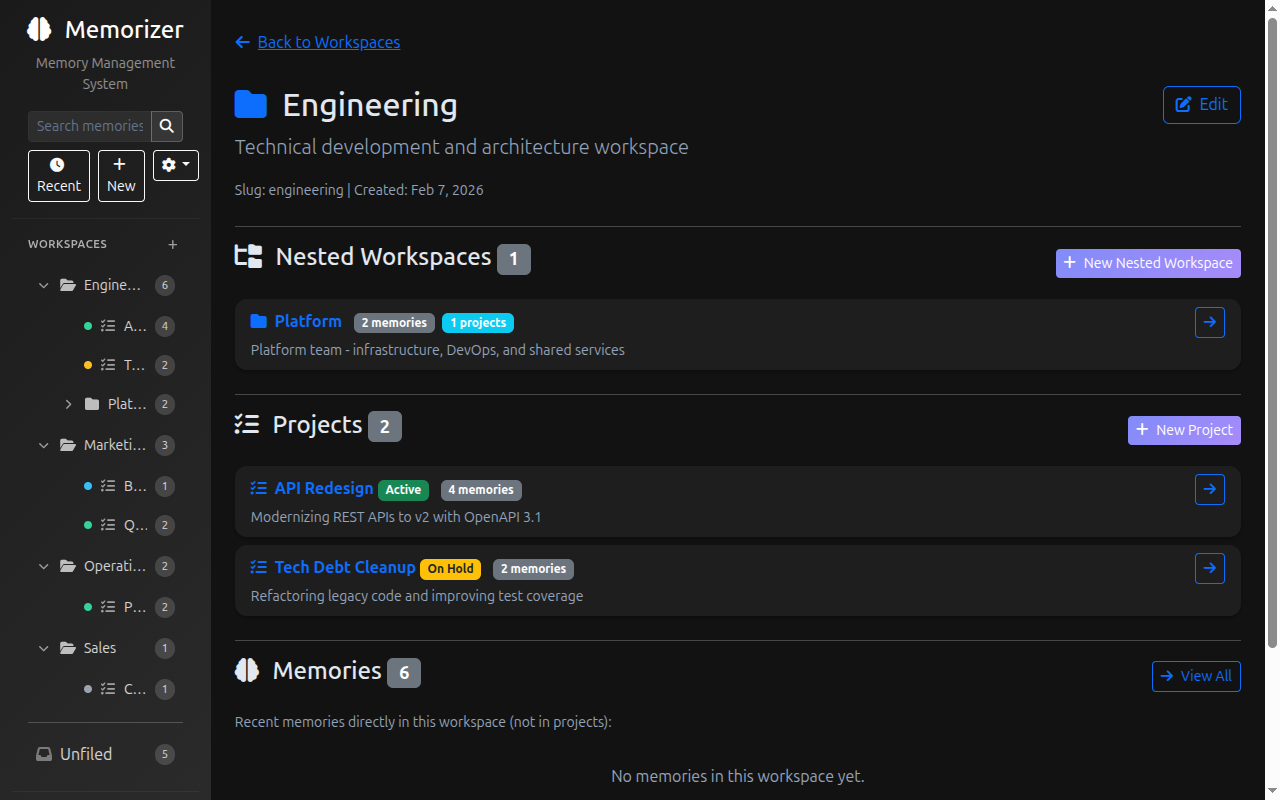
- Workspaces & Projects - Organize memories into hierarchical workspaces and projects with status tracking
- Store structured memories with vector embeddings
- Retrieve memories by ID
- Semantic search through memories using vector similarity
- Filter search results using tags
- Edit memory content with automatic versioning and change tracking
- Update memory metadata (title, type, tags, confidence) independently
- Revert memories to previous versions with full audit trail
- Create relationships between memories to form knowledge graphs
- Web UI for manually adding, editing, deleting, viewing memories, and managing versions
- Provider Settings - Configure embedding and LLM providers through the UI (Ollama, OpenAI, and compatible APIs)
- MCP (Model Context Protocol) integration for easy use with AI agents
- Light & Dark theme support
Technologies
- .NET 10.0
- PostgreSQL with pgvector extension
- Model Context Protocol (MCP)
- ASP.NET Core
- Akka.NET for background jobs, such as re-embedding memories if you change algorithms
- Npgsql for PostgreSQL connectivity
📖 Documentation
- Feature Gallery (Screenshots)
- Configuration & Advanced Setup
- Security Configuration
- Embedding Models & Dimensions
- Embedding Dimension Migration
- Local Development
- Schema Migrations
- Architecture Decision Records
Installation with Docker
🐳 Quick Start (Public Image)
The easiest way to get started is using the pre-built Docker image and our docker-compose.yml file:
docker-compose up -d
This will:
- Download and run the latest
petabridge/memorizerimage from Docker Hub - Start PostgreSQL with pgvector (port 5432)
- Start PgAdmin (port 5050)
- Start Ollama (port 11434)
Установка
docker exec postgmem-postgres pg_dump -U postgres postgmem > memorizer-backup-$(date +%Y%m%d).sql